GPT Image 2.5 正式发布!更快、更精准、更懂你心意,“免越狱” 生成高清美图,AI 生图进入全新阶段
OpenAI 正式发布了新一代图像生成模型 ChatGPT Images 2.5。这一次升级并不是简单地提升图片分辨率或者增加几个新功能,而是从生成速度、图像一致性、精准编辑、多轮修改、参考图理解以及创作工具等多个方面进行了全面升级。
更重要的是,ChatGPT Images 2.5 已经向 ChatGPT、ChatGPT Work 和 Codex 用户开放,并覆盖 Web、桌面端和移动端。与此同时,OpenAI 还推出了 API 版本的 GPT-Image-2.5 Flare 和 GPT-Image-2.5 Sunburst。
我第一时间体验之后最大的感受就是:GPT Image 2.5 真的变得更快、更精准,也更加“懂你想要什么”。而且相比上一代大模型,明显更开放,以前需要越狱才能生成的美图,现在几乎都可以秒生成!
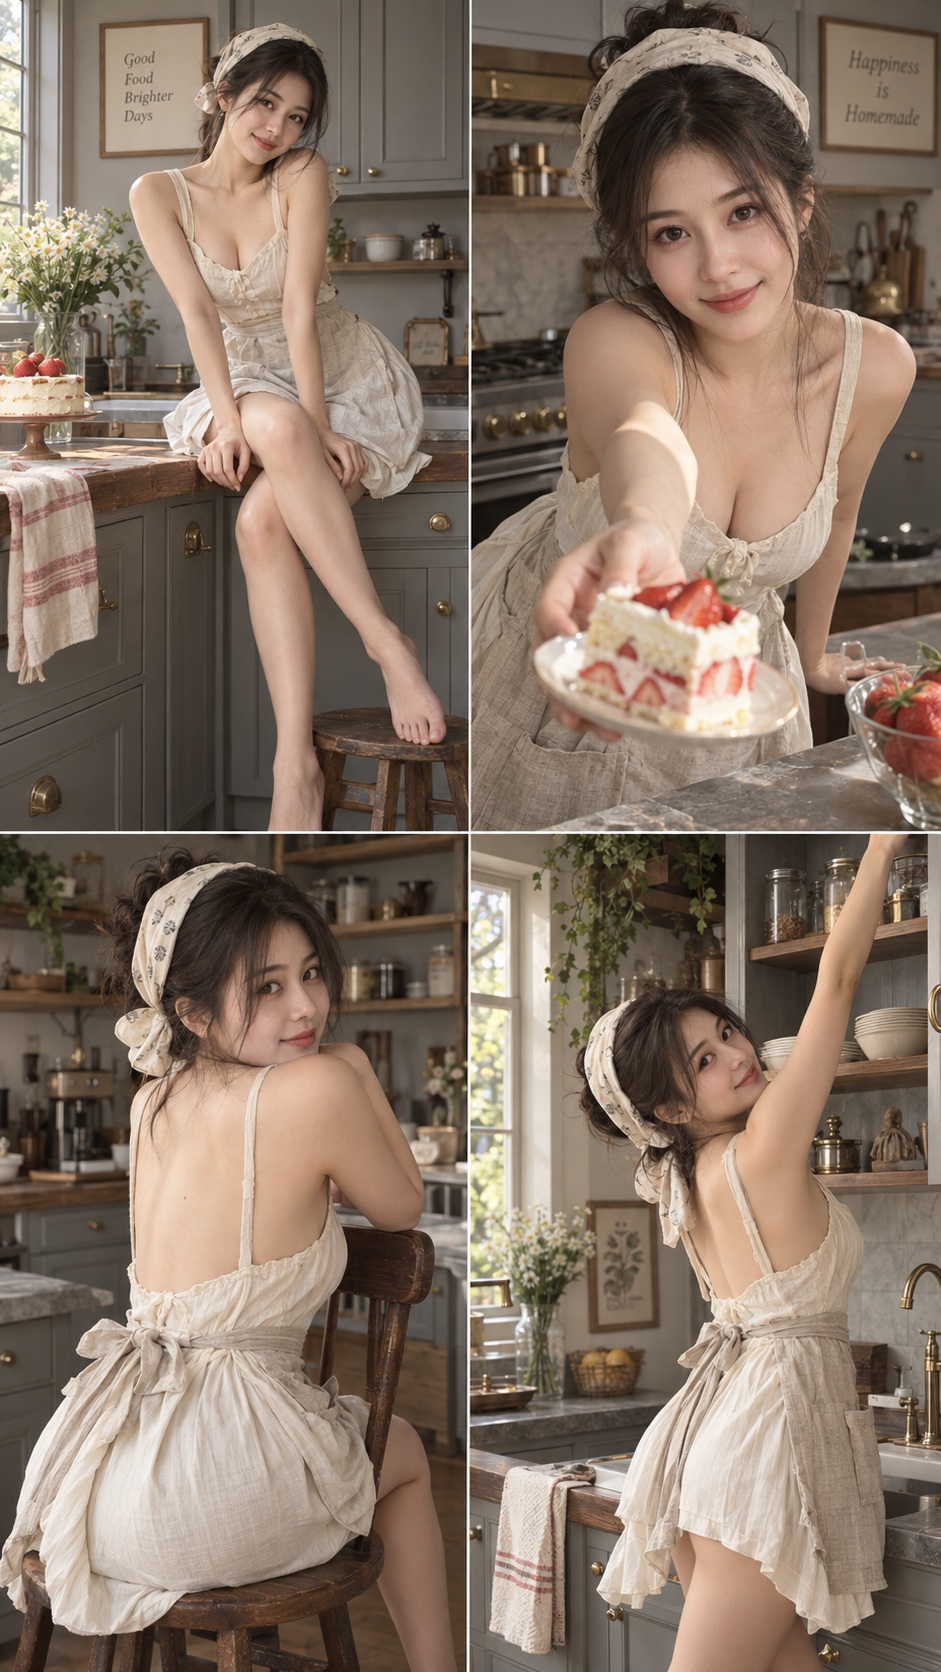
提示词:
创建一系列9:16比例的照片级复古面包师肖像,带有柔和、亲密的视角感。

在整组作品中使用同一位美丽的成年东亚女性,保持直接眼神接触,逼真的皮肤纹理,柔软自然的头发,以及感性却自然的呈现。她穿着简约的无袖夏季厨房连衣裙,颜色为象牙白或柔和奶油色,搭配轻薄围裙和精致的头巾。场景设定为精致的复古Shaker风格厨房,配备蘑菇灰色橱柜、深胡桃木台面、温暖的灰色石质表面、细致的黄铜五金,以及清澈的夏季日光。

本批次应更注重肢体语言、眼神接触和姿势几何,而非大型动作场景。女性必须在每一帧中保持清晰的视觉焦点。

包含优雅的厨房肖像瞬间,例如:

* 坐在台面上,一条长腿伸展,另一只脚放在凳子上

* 向观众递出一片草莓蛋糕

* 背对坐在高脚凳上,双臂搭在椅背上

* 在厨房中向上伸手,同时与镜头保持俏皮的连接

保持复古、女性化、俏皮且略带调情的情调。每张图像都应感觉像是同一复古厨房场景中捕捉到的瞬间,观众仿佛近距离站在她身边。

在系列中变换面部角度。不要在每张图像中重复相同的四分之三侧脸。使用正面眼神接触、侧脸瞥视、基于轮廓的眼神接触、上扬目光,以及略微低垂下巴配以上挑眼睛的组合,让整组作品感觉生动而非同一张脸贴在不同姿势上。

使用姿势、肩膀、腰线、长腿和眼神接触作为视觉兴趣的主要来源。姿势应感觉放松却有意,带有轻微的编辑风格品质。

道具必须保持次要地位。如果出现道具,保持它们小巧且辅助性,例如一片草莓蛋糕、一把木勺、一个打蛋器、小托盘、一块折叠的亚麻布,或一个小玻璃罐。避免超大不透明物体、大碗或笨重的炊具,这些会遮挡躯干或抢走模特的注意力。

光线应柔和、干净且夏季感十足。整体色调平衡保持中性至略暖。复古感必须源于厨房风格、服装、纹理和氛围——而非沉重的黄色或橙色滤镜。皮肤应保持自然,象牙白服装应保持象牙白,灰色橱柜应保持灰色。

最终结果应感觉亲密、时尚、女性化、复古且编辑风格,带有逼真的解剖结构、逼真的皮肤、可信的表情,以及一个有生活痕迹却优雅的厨房环境。

避免重复的面部角度、生硬的姿势、超大道具、黄色色偏、橙色皮肤、扭曲的手部、夸张的广角身体变形、杂乱的背景、复杂的肩带设计,以及明显的AI生成瑕疵。
那么OpenAI 最新发布的 GPT Image 2.5 ,相比开源且非常热门的 Z-Image 文生图模型有什么区别呢? Z-Image 主打的就是无审查,免越狱生成无法描述的内容,接下来我们就来测试下!
部署教程
1、安装 ComfyUI
官方下载:【点击前往】
2、安装无审查的 Z-Image 模型
免安装部署(一键赖人包)
如果你没时间想看教程,不想通过手动下载安装,或者网络环境不允许,那么你可以选择直接打开下方的模型整合包,进行免手动部署
Z-Image 模型整合包下载: 【点击前往】 或 【备用下载】
【零度同款】TDM Fast 下载器:【点击前往】
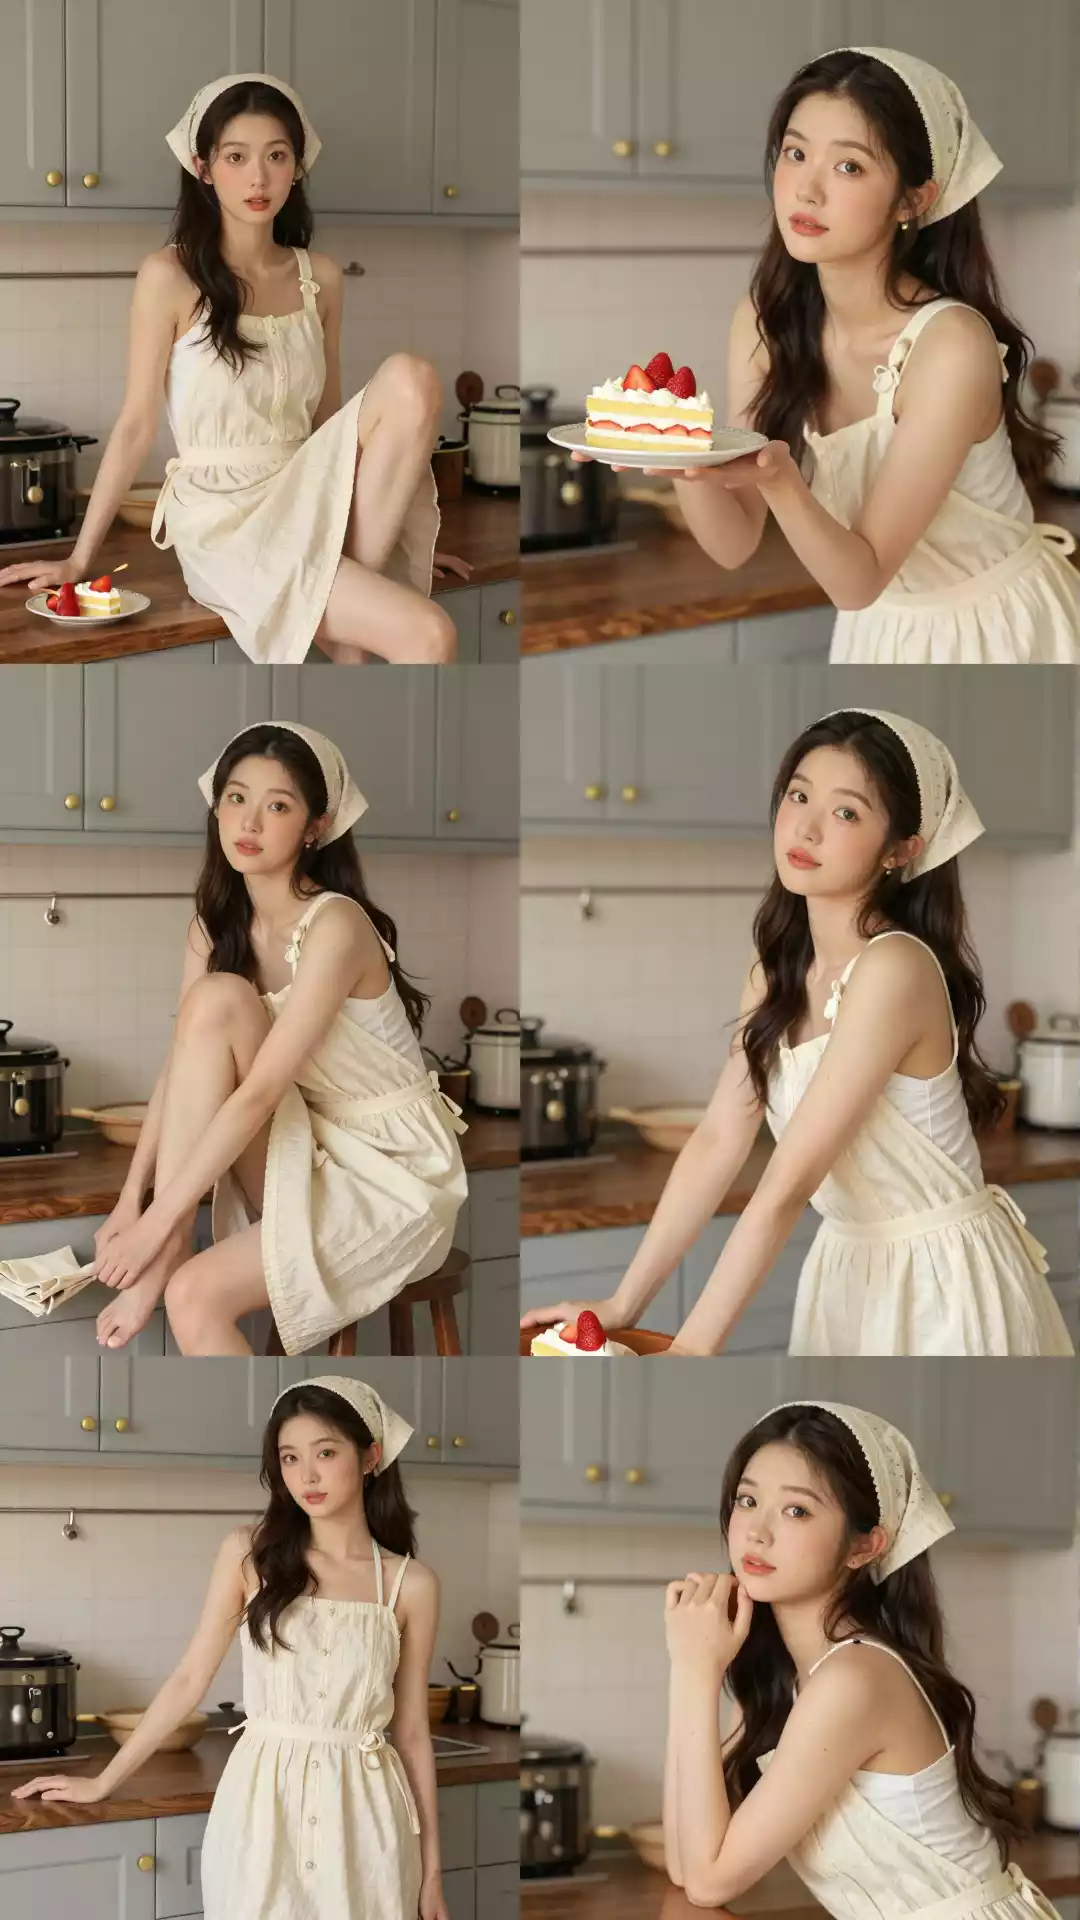
在使用相同的提示词下,生成的效果如上图所示,我们可以进行对比下,下方的图片中,左侧是GPT Image 2.5生成的,右侧是Z-Image生成的结果,大家觉的哪个更胜一筹呢?
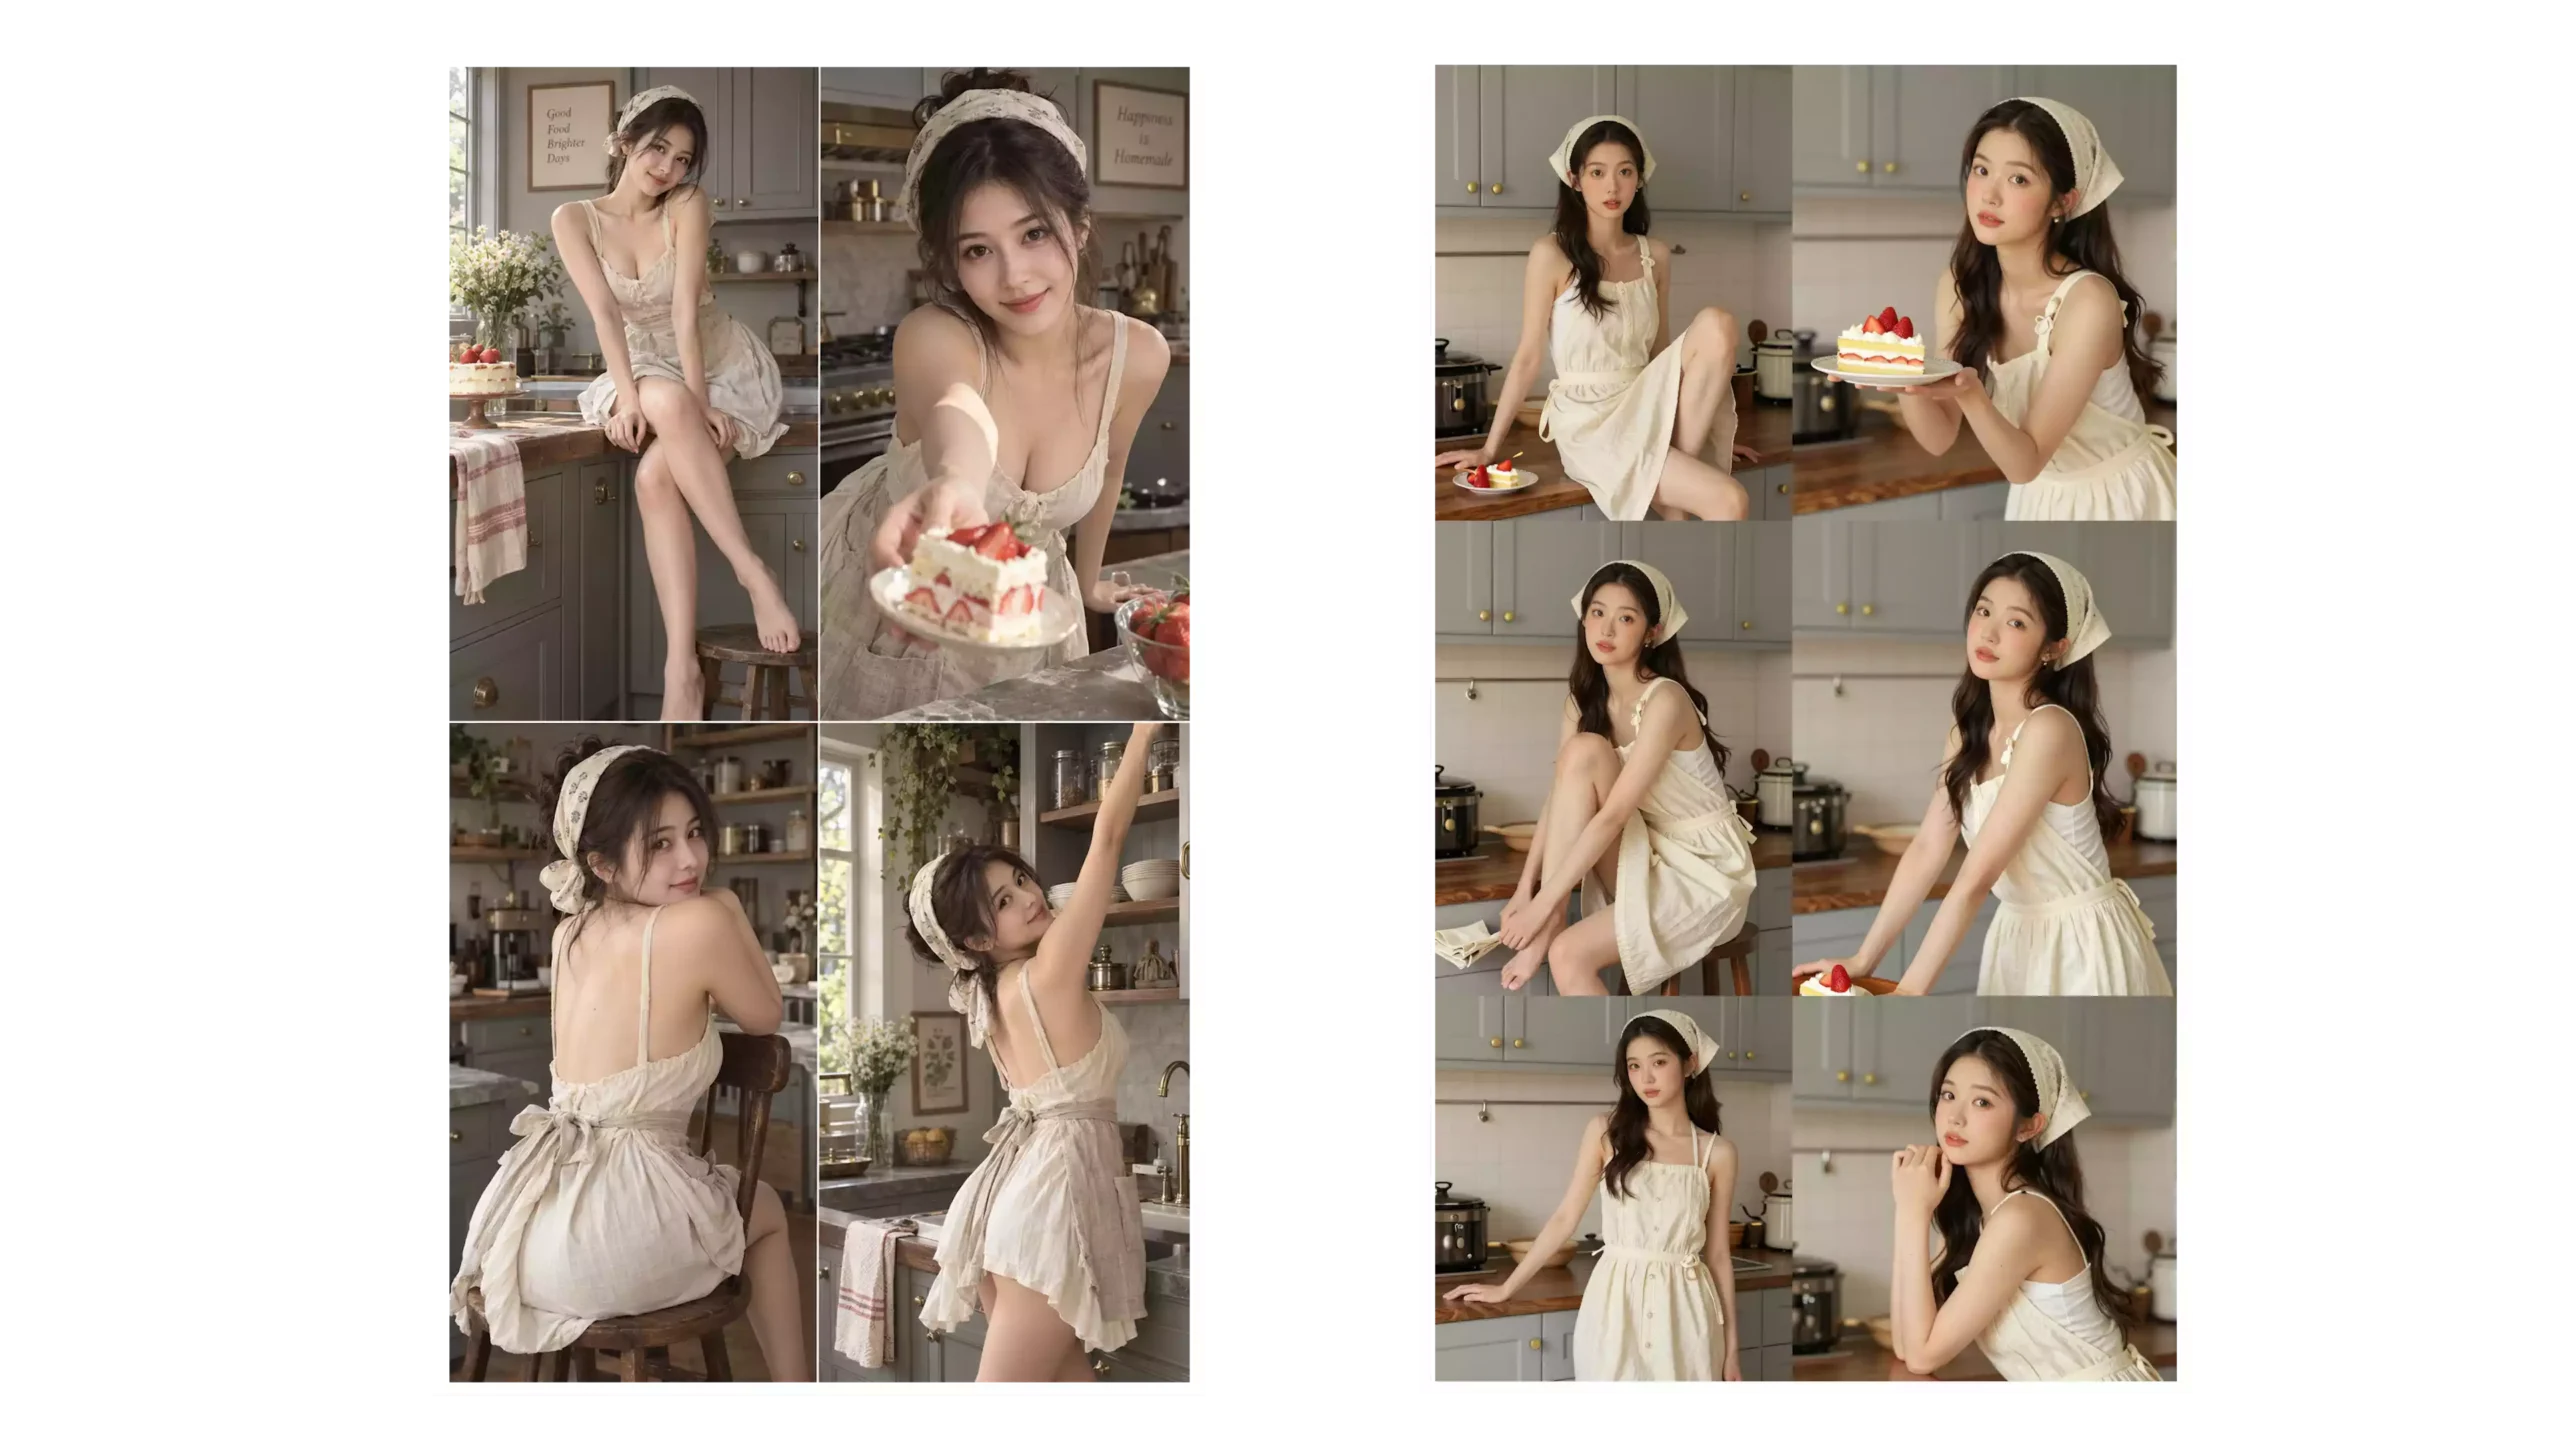
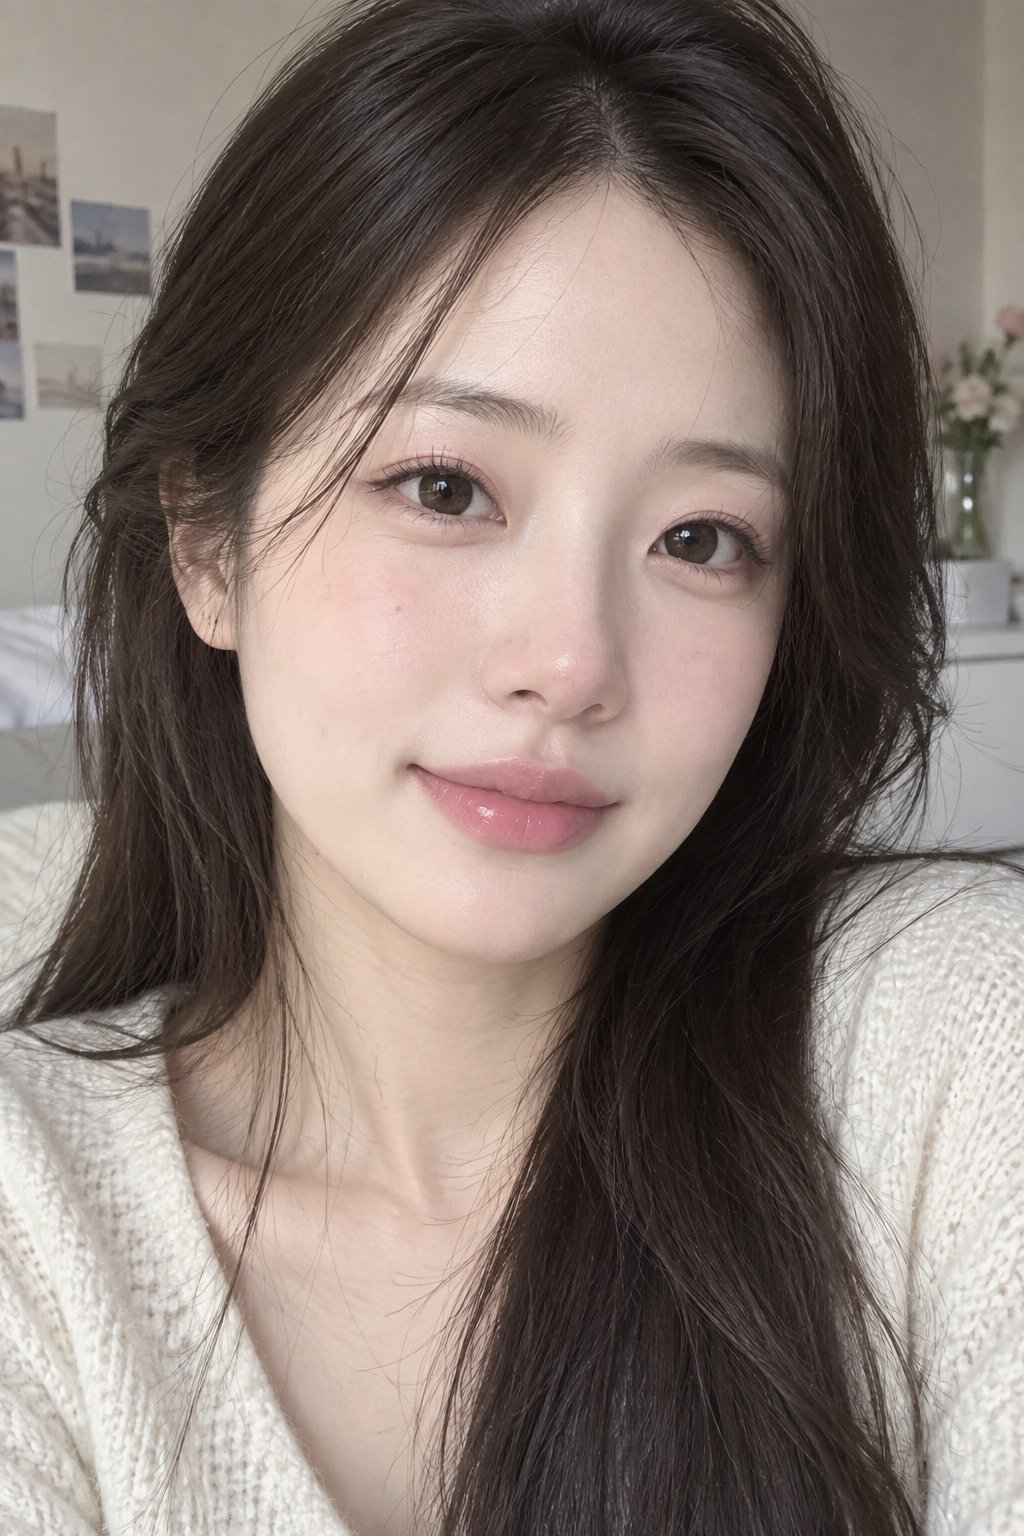
GPT Image 2.5 生成重在细节性,Z-Image 重在真实且无审查,但说实话,两者的差距已经非常小了~~ 当然后者是完全免费开源的,可以本地自由生成任何你需要的图片!Z-Image的本地部署教程,我们之前已经给大家做过了,没看过的可以看下方的视频教程!含越狱模型下载
一、GPT Image 2.5 到底升级了什么?
OpenAI 将这次升级概括为几个关键词:
- 更快的图像生成
- 更高的图像保真度
- 更精准的图像编辑
- 更好的多轮编辑一致性
- 更强的复杂指令理解
- 更好的文字与布局处理
- 全新的 Sketch 绘图功能
- Templates 模板
- 基于评论的精准编辑
其中最值得关注的,我认为并不是单纯的画质提升,而是:
“保持不该改变的东西不变。”
这其实是 AI 图像生成长期以来非常难解决的问题。
OpenAI 表示,Images 2.5 在参考图生成方面能够更好地保持人物、物体的身份特征,同时让光照、纹理和细节更加自然。
二、最大的提升:图像一致性
如果你经常使用 AI 生图,应该非常清楚一个痛点。
假设你生成了一张人物照片,然后告诉 AI:
把衣服换成黑色。
理论上,AI 应该只修改衣服。
但以前很多模型可能会顺便改变:
- 人物脸部
- 发型
- 手部
- 背景
- 光线
- 姿势
- 甚至整个构图
最终你得到的是一张“类似的图片”,而不是同一张图片的精准修改版本。
而 GPT Image 2.5 明显加强了这一能力。
OpenAI 官方特别强调,Images 2.5 能够更加精准地只修改用户要求改变的内容,同时尽可能保持其他细节不变。即使面对复杂人物和背景,也能更好地维持原始构图和视觉身份。
这对于实际创作非常重要。
因为真正的商业设计往往不是:
“帮我重新生成一张图片。”
而是:
“保持其他全部不变,只把这里改一下。”
这才是专业图像编辑真正需要的能力。
三、多轮编辑终于更加可靠
另一个非常重要的升级,是多轮编辑的一致性。
以前使用 AI 修改图片,经常会出现这样的情况:
第一轮:
把衣服改成红色。
第二轮:
把背景换成城市。
第三轮:
把人物表情改得更加自然。
第四轮:
再把鞋子换成白色。
修改到最后,你可能会发现:
人物已经不是最开始那个人了。
GPT Image 2.5 针对这一问题进行了优化。
OpenAI 表示,在较长的 ChatGPT 对话中,Images 2.5 能够更加可靠地遵循连续的编辑指令,让之前完成的修改保持下来,并让后续编辑建立在之前的结果之上,而不是不断破坏之前的细节。
这对于商业设计尤其重要。
例如制作一套品牌广告时,可以先确定人物和产品,然后连续修改:
人物 → 背景 → 产品 → 文案 → 色彩 → 构图
而不需要每一步都重新生成。
四、速度也明显提升
除了质量之外,速度也是这一次升级的重点。
OpenAI 表示,ChatGPT Images 2.5 相比 Images 2.0,图像生成延迟最高降低了 50%。
这意味着什么?
以前你可能会因为等待生成而不断思考:
“要不要换一个 Prompt?”
而现在可以更加快速地:
生成 → 修改 → 再生成 → 再修改。
对于创作者来说,这种速度提升其实非常重要。
因为 AI 创作最重要的并不是一次生成完美结果,而是:
快速试错。
生成速度越快,创作迭代的成本就越低。
五、GPT Image 2.5 + Sketch:不会画画也能表达创意
这次我认为非常有意思的一个功能,是 Sketch。
有时候,我们脑子里明明有一个非常明确的画面,却很难用文字描述出来。
比如:
人物站在左边。
产品放在右边。
中间是一条巨大的光带。
背景是城市。
如果只用文字描述,很容易出现偏差。
但现在可以直接在 ChatGPT 里面:
随手画几笔。
哪怕只是几个非常粗糙的线条,也可以把它作为视觉参考。
OpenAI 官方介绍,Sketch 可以让用户直接在 ChatGPT 中绘制草图,然后让模型根据草图生成完整图片。用户甚至不需要具备专业绘画能力,只需要表达基本的构图、轮廓或者想法即可。输入 “@Sketch” 就可以使用。
这实际上改变了人与 AI 沟通的方式。
以前是:
想法 → Prompt → AI
现在变成:
想法 → 草图 + Prompt → AI
而对于设计师、摄影师、视频创作者来说,草图往往比文字更加准确。
六、从几根乱线,到真正可以使用的设计
这也是 GPT Image 2.5 最让我惊讶的地方之一。
你甚至不需要画得好。
随便画几条线,告诉 AI:
“按照这个构图生成一张高级感的商业广告。”
AI 就可以根据这些非常粗糙的视觉信息,推断出:
- 构图
- 主体位置
- 视觉层级
- 光影
- 色彩
- 风格
- 空间关系
然后把一个非常粗糙的草图变成完整的视觉作品。
这意味着:
AI 正在把“表达创意”的门槛进一步降低。
不会 Photoshop,可以。
不会 Illustrator,也可以。
甚至不会画画,也没有关系。
只要你能大概画出:
“我想让它长这样。”
剩下的工作可以交给 AI。
七、文字和复杂布局也成为重点
AI 生图过去还有一个非常明显的问题:
文字。
尤其是海报、广告、产品包装、信息图等内容。
画面可能非常漂亮,但文字经常出现:
- 拼写错误
- 乱码
- 字体混乱
- 排版错位
- 信息缺失
而 GPT Image 2.5 进一步加强了对复杂视觉指令和布局的理解。
OpenAI 表示,Images 2.5 对真实世界信息的理解更准确,同时能够处理更加复杂的布局,包括透明背景等场景。
这让它特别适合:
创意广告
例如:
- 产品广告
- 时尚海报
- 运动宣传
- 品牌 KV
- 电商主图
商业设计
例如:
- 海报
- Flyer
- Merch
- 产品包装
- 社交媒体图片
内容创作
例如:
- YouTube 封面
- 视频插图
- 博客配图
- 信息图
- 社交媒体内容
八、AI 创意广告的工作流正在发生变化
过去做一张广告图,通常需要:
找参考 → 写文案 → 找素材 → PS 合成 → 调色 → 排版 → 修改
如果要制作十个不同版本,工作量会非常大。
而现在,可以直接让 GPT Image 2.5:
一次生成多个创意方向。
例如同一个产品,可以要求:
科技风
极简风
高端奢侈品风
电影感
运动广告风
未来主义
然后再选择其中一个方向继续修改。
这对于电商和广告行业来说,意义非常大。
因为以前一个创意可能需要几个小时甚至一天才能完成。
现在可能几分钟就可以产生几十个方向。
AI 不一定直接替代设计师,但它正在极大压缩创意验证的成本。
九、GPT Image 2.5 开始真正进入“视频工作流”
更有意思的是,GPT Image 2.5 并不只适合制作静态图片。
现在已经出现了很多非常有意思的工作流:
GPT Image 2.5 → 图像 → AI 视频模型 → 视频
例如先使用 GPT Image 2.5 制作统一风格的关键帧,再使用视频模型生成动态效果。
社区已经出现了将 GPT Image 2.5 与 MiniMax H3、Seedance 2.5 等模型结合制作 AI 视频的案例。
这种工作流实际上非常合理:
GPT Image 2.5 负责视觉设计和画面一致性。
视频模型负责让画面动起来。
这样就可以把 AI 生图和 AI 视频结合起来。
十、GPT Image 2.5 Sunburst:真正值得关注的版本
如果你使用 API,还需要了解这次推出的两个模型:
GPT-Image-2.5 Flare
Flare 更偏向于:
速度 + 质量 + 大规模生成。
OpenAI 表示,Flare 是 API 中面向大多数应用的默认选择,在质量、编辑能力和速度方面相比 GPT-Image-2 有明显提升,并且延迟降低约 50%。
它适合:
- 社交媒体内容
- 创作者工具
- 产品体验
- 电商
- 视觉搜索
- 快速原型
- 大规模图片生成
GPT-Image-2.5 Sunburst
Sunburst 则更加偏向:
高质量 + 高精度 + 专业创作。
OpenAI 将它定位为适用于高级视觉工作流的模型,尤其适合需要更严格编辑控制的场景,例如:
- 商业广告
- 产品摄影
- 品牌视觉
- 高质量创意
- 专业图像编辑
代价则是更长的生成时间。
简单理解:
Flare = 更快
Sunburst = 更精细
十一、Sunburst 的真正杀手锏:只改变你想改变的东西
这也是目前 GPT Image 2.5 最值得关注的能力之一。
比如原本是一张人物广告图。
现在要求:
把手里的手机换成一瓶饮料。
理想状态应该是:
手机变成饮料。
而不是:
手机变饮料 + 人脸变了 + 背景变了 + 光线变了 + 衣服变了。
Sunburst 强化的就是这种精准编辑能力。
InVideo 最近展示了一个非常有意思的工作流:
先利用 GPT-Image-2.5 Sunburst 对画面中的对象进行精准替换,再利用 InVideo 的 AI 编辑 Agent 自动构建时间线并对齐不同编辑后的画面,从而制作出 Match Cut 效果。
这种工作流真正有意思的地方,并不是某一张图片有多漂亮。
而是:
AI 开始参与整个视频制作流程。
从:
图片生成
到:
图片编辑
再到:
时间线排列
最后:
视频剪辑
越来越多工作开始交给 AI Agent 完成。
十二、Templates:不会写 Prompt,也可以开始创作
除了 Sketch,OpenAI 这一次还加入了 Templates。
对于很多普通用户来说,最大的困难其实不是模型不够强。
而是:
不知道应该怎么开始。
因此,Images 2.5 提供了一些常见创作格式的模板,例如:
- Poster
- Merch
- 产品图片
- 社交媒体内容
用户只需要选择模板,再补充自己的内容、设计元素和风格即可。
这实际上又一次降低了 AI 创作门槛。
十三、分享图片的时候,现在连 Prompt 都可以分享
另一个比较实用的功能,是分享图片时可以选择同时分享生成它所使用的 Prompt。
这样别人看到你的作品后,可以直接基于相同的创意继续创作。
例如:
你的照片 + 我的 Prompt
可以变成:
你的照片 + 相同 Prompt = 完全属于你的版本。
这会让 AI 图片创作逐渐形成一种新的内容传播方式:
图片本身是一种内容,Prompt 也成为内容的一部分。
十四、GPT Image 2.5 正在改变什么?
如果只看参数、分辨率和生成速度,GPT Image 2.5 可能只是一次普通的模型升级。
但如果把这些能力放到一起,你会发现变化其实非常大。
过去:
人 → 学习 Photoshop → 学习 Prompt → 学习剪辑 → 制作作品
现在:
人 → 表达创意 → AI 负责执行
而 Sketch 解决的是:
“我不会描述。”
精准编辑解决的是:
“我只想改这里。”
多轮一致性解决的是:
“不要把之前的东西弄坏。”
Templates 解决的是:
“我不知道怎么开始。”
更快的生成速度解决的是:
“我想快速试错。”
AI Agent 则进一步解决:
“这些事情能不能让 AI 自己完成?”
十五、结语:AI 生图正在从“生成工具”变成“创作伙伴”
GPT Image 2.5 真正值得关注的,并不只是它生成的图片更加漂亮。
更重要的是:
AI 正在越来越理解“创作者真正想改变什么”。
从以前的:
“帮我生成一张图片。”
逐渐变成:
“这是我的草图,按照这个构图做。”
“人物保持不变,只换衣服。”
“保持这个产品和品牌风格,再做五个广告版本。”
“把这些图片做成一个完整的视频。”
这意味着 AI 生图正在从一个单纯的内容生成工具,逐渐变成整个创作流程中的核心基础设施。
而 GPT Image 2.5 的这次升级,可能只是一个开始。
未来真正强大的创作方式,很可能不再是:
一个人掌握 Photoshop、Premiere、After Effects、摄影和设计。
而是:
一个人 + 一套 AI Agent 工作流。
你负责提出创意。
AI 负责执行。
而这,可能才是 AI 真正改变内容创作行业的方式。
暂无评论
还没有评论,快来抢沙发吧!